# 'glyf' 表 (glyph data table)
'glyf' 表包含定义字体中字形外观的数据。 这包括描述构成字形轮廓的轮廓的点的规范以及网格拟合该字形的指令。 'glyf' 表支持简单字形和复合字形的定义,即由其他字形组成的字形。
字体中的字形数量仅受“head”表中规定的值的限制。 字形在字体中的放置顺序是任意的。
请注意,字体必须至少有两个字形,并且字形索引 0 必须有轮廓。 有关详细信息,请参阅字形映射 (opens new window)。
# 表组成描述
“glyf”表由一系列字形数据块组成,每个数据块都提供单个字形的描述。 字形由标识符(字形 ID)引用,标识符是从零开始的连续整数。 字形的总数由“maxp”表中的 numGlyphs 字段指定。 “glyf”表不包括任何整体表头或提供字形数据块偏移量的记录。 相反,'loca' 表提供了一个偏移数组,由 glyph ID 索引,它提供了 'glyf' 表中每个 glyph 数据块的位置。 请注意,“glyf”表必须始终与“loca”和“maxp”表一起使用。 每个字形数据块的大小是从“位置”表中两个连续偏移之间的差异推断出来的(提供了一个额外的偏移来给出最后一个字形数据块的大小)。 作为“local”格式的结果,“glyf”表中的字形数据块必须按字形 ID 顺序排列。
每个字形描述使用以下两种格式之一:
简单字形描述直接使用贝塞尔控制点指定字形轮廓。 复合字形描述通过引用一个或多个字形 ID 来间接指定字形轮廓以用作组件。 在这两种情况下,字形描述都以字形标题开头,这两种字形描述都通用。
# 字形数据
表 14 记录了字形定义的格式。 零或正数量的轮廓表示一个简单的字形。 如果轮廓数小于零,则字形由组件组成。 如果字形的轮廓为零,则它不需要任何字形数据。 如果字形由组件组成,建议在此字段中使用值 -1。
字形中坐标数据的最小和最大 x 和 y 值定义字形的边界框。 这是在进行任何网格拟合之前原始字形轮廓的边界框。
表 14:字形描述
| 类型 | 名称 | 描述 |
|---|---|---|
| int16 | numberOfContours | 如果轮廓数为正数或为零,则为单个字形; 如果轮廓数小于零,则字形是复合的 |
| FWord | xMin | 坐标数据的最小 x |
| FWord | yMin | 坐标数据的最小 y |
| FWord | xMax | 坐标数据的最大 x |
| FWord | yMax | 坐标数据的最大 y |
| (以下是简单或复合字形的数据) | ||
# 简单的字形
表 15 指定了简单字形的格式。 字形轮廓要求的更详细描述在数字化字母设计中给出 (opens new window)。
表 15:简单的字形定义
| 类型 | 名称 | 描述 |
|---|---|---|
| uint16 | endPtsOfContours[n] | 每个轮廓的最后一个点的数组; n 是轮廓的数量; 数组的项是点索引 |
| uint16 | instructionLength | 指令所需的总字节数(每个指令所占空间为一个字节。或者说是指令总数) |
| uint8 | instructions[instructionLength] | 此字形的指令数组 |
| uint8 | flags[variable] | flags数组 |
| uint8 or int16 | xCoordinates[] | x 坐标数组; 第一个是相对于 (0,0),其他的是相对于前一点 |
| uint8 or int16 | yCoordinates[] | y 坐标数组; 第一个是相对于 (0,0),其他的是相对于前一点 |
flags 数组中的每个条目的大小都是一个字节。与该字节中的每个位相关联的含义在下面的表 16 中给出。
从逻辑上讲,每个点都有一个标志字节元素、一个 x 坐标和一个 y 坐标。 坐标点的数量由 endPtsOfContours 数组中的最大一项确定(opentype endPtsOfContours 是按升序排列的,最大点即最后一项)。
表 16:大纲标志(Outline flags)
| Mask | Flags | Bit (0 是最后重要的bit) | 描述 |
|---|---|---|---|
| 0x01 | On Curve | 0 | 如果设置,则该点在曲线上; 否则,它是偏离曲线的。 |
| 0x02 | x-Short Vector | 1 | 如果设置1,则对应的 x 坐标为 1 个字节长; 否则,对应的 x 坐标为 2 个字节长 |
| 0x04 | y-Short Vector | 2 | 如果设置1,对应的y坐标为1字节长; 否则,对应的 y 坐标为 2 个字节长 |
| 0x08 | Repeat | 3 | 如果设置1,下一个字节指定这组标志要重复的额外次数。 这样,列出的标志数可以小于字符中的点数。 |
| 0x10 | This x is same (Positive x-Short vector) | 4 | 此标志具有两种含义之一,具体取决于 x-Short Vector 标志的设置方式。 如果设置了 x-Short Vector 位,则该位描述值的符号,值 1 等于正值,零值等于负值。 如果未设置 x-short Vector 位,而设置了该位,则当前 x 坐标与前一个 x 坐标相同。 如果 x-short Vector 位未设置,且该位未设置,则当前 x 坐标是有符号的 16 位增量向量。 在这种情况下,增量向量是 x 的变化 |
| 0x20 | This y is same (Positive y-Short vector) | 5 | 此标志具有两种含义之一,具体取决于 y-Short Vector 标志的设置方式。 如果设置了 y-Short Vector 位,则该位描述值的符号,值 1 等于正值,零值等于负值。 如果未设置 y-short Vector 位,而设置了该位,则当前 y 坐标与前一个 y 坐标相同。 如果 y-short Vector 位未设置,且该位未设置,则当前 y 坐标是一个带符号的 16 位增量向量。 在这种情况下,增量向量是 y 的变化 |
| 0x80 | Reserved | 6 - 7 | 设置为零 |
如何理解
Bit 列中的数字代表8位二进制的数值索引,从低位到高位;0代表8位二进制中的最低位;例如00111111代表当前flag全部设置了。00000001代表当前flag只设置了On Curve
# 复合字形
复合字形是由两个或多个组件字形组成的字形。 复合字形描述的开头就像一个简单的字形描述,有四个词描述了边界框。 它后面是 n 个分量字形部分。 每个组成字形部分由一个标志条目、两个偏移条目和一到四个转换条目组成。
描述复合字形中每个组成字形的格式记录在表 17 中。与第一个条目中的标志相关的含义在表 18 中给出。
表 17:组件字形部分说明
| 类型 | 名称 | 描述 |
|---|---|---|
| uint16 | flags | 组件标志 |
| uint16 | glyphIndex | 组件的字形索引 |
| int16, uint16, int8 or uint8 | argument1 | 组件或点编号的 X 偏移; 类型取决于组件标志中的位 0 和 1 |
| int16, uint16, int8 or uint8 | argument2 | 组件或点编号类型的 Y 偏移取决于组件标志中的位 0 和 1 |
| 转换选项 | 表 19 中的转换选项之一 | |
表 18:组件标志
| Mask 16进制 | Flags | Bit | 描述 |
|---|---|---|---|
| 0x0001 | ARG_1_AND_2_ARE_WORDS | 0 | 如果设置,则参数为单词16-bit (uint16 或 int16); 如果未设置,则它们是字节。(uint8 or int8) |
| 0x0002 | ARGS_ARE_XY_VALUES | 1 | 如果设置,则参数为有符号 xy 值; 如果未设置,则为无符号点。 |
| 0x0004 | ROUND_XY_TO_GRID | 2 | 如果设置,则将 xy 值四舍五入到网格; 如果未设置,则不将 xy 值舍入到网格(仅与设置的位 1 相关) |
| 0x0008 | WE_HAVE_A_SCALE | 3 | 如果设置,则组件有一个简单的比例。 如果未设置,比例为 1.0。 |
| 0x0010 | (此位已废弃) | 4 | (已过时;设置为零) |
| 0x0020 | MORE_COMPONENTS | 5 | 如果设置,则至少有一个额外的字形跟随此字形。 |
| 0x0040 | WE_HAVE_AN_X_AND_Y_SCALE | 6 | 如果设置 x 方向将使用与 y 方向不同的比例。 |
| 0x0080 | WE_HAVE_A_TWO_BY_TWO | 7 | 如果设置,则将使用 2×2 转换来缩放组件。 |
| 0x0100 | WE_HAVE_INSTRUCTIONS | 8 | 如果设置,则组件字符的说明位于最后一个组件之后。 |
| 0x0200 | USE_MY_METRICS | 9 | 将此组件中的度量用于复合字形。 |
| 0x0400 | OVERLAP_COMPOUND | 10 | 如果设置,此复合字形的组件将重叠。 |
# 表 19:转换选项
| 转换选项 | 含义 |
|---|---|
| transformation entry #1 | scale (same for x and y) |
| transformation entry #2 | x-scale |
| y-scale | |
| transformation entry #3 | xscale |
| scale01 | |
| scale10 | |
| yscale |
复合字形中的字形数据不同于简单字形的数据,它由每个组件的描述组成,然后是对整个复合字形的任何说明。
字形索引描述第 j 个分量字形的位置。
转换条目确定在组件被合并到父字形之前应用于组件的仿射转换的值。 给定组件矩阵 [a b c d e f],应用于组件的变换为:
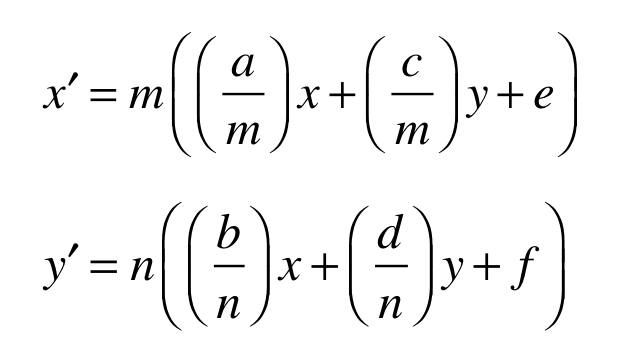
a、b、c和d的值如表19a中所示获得。 e 和 f 的值如下面的伪代码所示:
if (ARG_1AND_2_ARE_WORDS && ARGS_ARE_XY_VALUES)
	1st short contains the value of e
	2nd short contains the value of f
else if (!ARG_1AND_2_ARE_WORDS && ARGS_ARE_XY_VALUES)
	1st byte contains the value of e
	2nd byte contains the value of f
else if (ARG_1AND_2_ARE_WORDS && !ARGS_ARE_XY_VALUES)
	1st short contains the index of matching point in compound being constructed
	2nd short contains index of matching point in component
else if (!ARG_1AND_2_ARE_WORDS && !ARGS_ARE_XY_VALUES)
	1st byte containing index of matching point in compound being constructed
	2nd byte containing index of matching point in component
最后,m和n计算如下:
首先,让 m₀ = max(|a|, |b|) 和 n₀ = max(|c|, |d|)。
如果|(|a|-|c|)| ≤ 33/65536,则 m = 2m₀; 否则,m = m₀。
类似地,如果|(|b|-|d|)| ≤ 33/65536,则 n = 2n₀; 否则,n = n₀
如表19a所示导出线性变换数据。
重要的
如果 e 和 f 直接指定为偏移量而不是要匹配的点索引,则偏移量的正确值取决于转换组件。 例如,如果对组件应用二分之一的通用比例因子,则在使用 e 和 f 的值偏移组件之前,该比例因子也会应用于这些值。 另请注意,当组件旋转 45 度的倍数时,比例因子将翻倍。 由于这些原因,通过使用锚点和匹配点指定偏移比直接通过偏移值容易得多。
表 19a:线性变换
| WE_HAVE_A_SCALE | WE_HAVE_AN_X_AND_Y SCALE | WE_HAVE_A_TWO_BY_TWO | a | b | c | d |
|---|---|---|---|---|---|---|
| 0 | 0 | 0 | 1.0 | 0.0 | 0.0 | 1.0 |
| 1 | 0 | 0 | 1st short | 0.0 | 0.0 | 1st short |
| 0 | 1 | 0 | 1st short | 0.0 | 0.0 | 2nd short |
| 0 | 0 | 1 | 1st short | 2nd short | 3rd short | 4th short |
存储为 short 的数字被视为有符号的固定二进制小数点数,二进制小数点左侧一位,右侧 14 位。
可以认为转换和指令的应用按以下顺序发生:
对于每个组件
- 应用本地转换(如果有)
- 应用全局变换(例如点大小、分辨率)
- 网格拟合轮廓
- 应用偏移量或锚点的平移
- 如果有说明,则对复合字形进行网格拟合